Czym jest Antigravity CLI
agy to agent uruchamiany z terminala na koncie Google (tu: Google AI Pro). Potrafi czytać pliki, edytować je, uruchamiać komendy i raportować wynik — czyli wykonać całe zadanie, nie tylko doradzić. Z tego wynikają dwa obowiązki: dobrze wybrać model i sprawdzić artefakt, a nie tylko podsumowanie.
To narzędzie nie zastępuje operatora wdrożeń. Wdrożenie nadal idzie przez deploy.cmd (snapshot, kontrole, smoke test), a agy może przygotować zmianę i ją zweryfikować.
Dostępne modele
Listę modeli w danej chwili pokazuje agy models. Rodziny różnią się nie tylko ceną, ale i charakterem pracy:
| Model | Koszt | Charakter |
|---|---|---|
gemini-3.8-flash (low / medium / high) | najniższy | szybki i tani; prosty kod, dużo wywołań, rutynowe komendy |
gemini-4-argon (medium / high) | średni | codzienny kod, analiza plików, generowanie treści — dobry balans |
gpt-oss-120b (medium) | tani | praca tekstowa, research; słabsze narzędzia, nie do wdrożeń |
claude-sonnet-5-5 (medium) | średni | stabilne tool-use: edycja plików, audyty, weryfikacja — rekomendowany default |
claude-opus-5-5 (high) | najwyższy | najwyższa jakość przy ryzykownych zmianach i trudnych decyzjach |
Który model do czego
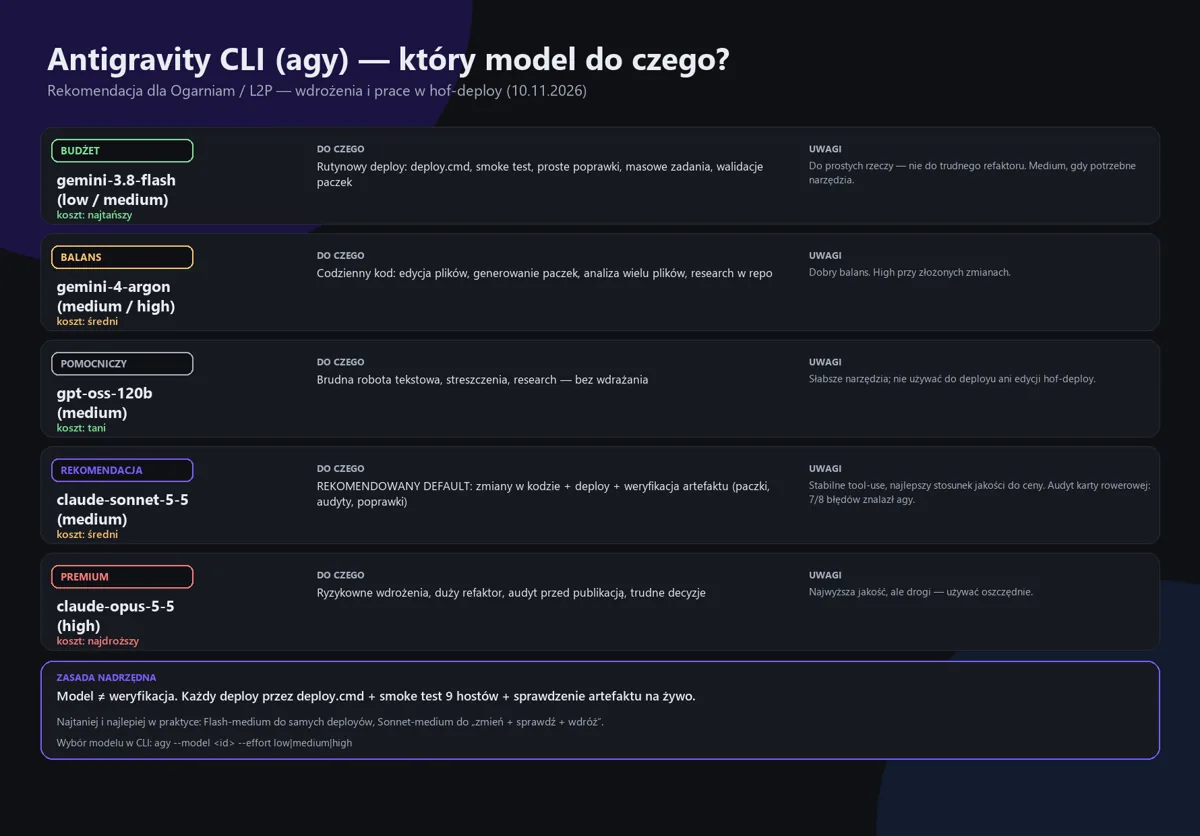
Nie chodzi o to, żeby zawsze brać najmocniejszy model. Chodzi o to, żeby nie płacić za moc, której zadanie nie potrzebuje — i nie oszczędzać tam, gdzie błąd kosztuje więcej niż tokeny.
- Rutynowe wdrożenie (bez zmian w kodzie):
gemini-3.8-flash-medium. Wystarczy do uruchomieniadeploy.cmd, odczytania logu i sprawdzenia smoke testu. - Kod + wdrożenie (poprawki plików, paczki, refaktor):
claude-sonnet-5-5-medium. To rekomendowany default: stabilnie trzyma kontekst narzędzi i rzadziej „poprawia" niepotrzebnie. - Budżetowo, dużo wywołań:
gemini-3.8-flash-low— tylko proste zadania, bez ryzyka. - Ryzyko i duży zakres:
claude-opus-5-5-highlubgemini-4-argon-high— oszczędnie, gdy błąd jest drogi.
Praktyczny wniosek: Flash-medium do samych deployów, Sonnet-medium do „zmień + sprawdź + wdróż". Limit jest wspólny z Google AI Pro (odświeżanie co 5 h i limit tygodniowy), więc masowe zadania powinny iść na Flash, a nie na Opus.
Jak wywołać model
Model wybiera się flagą --model, a głębokość rozumowania — --effort. Krótkie polecenie można podać przez -p, ale dla wieloliniowych zadań zawsze przez stdin:
$agy="$env:LOCALAPPDATA\agy\bin\agy.exe"
Get-Content zadanie.txt -Raw | & $agy --model claude-sonnet-5-5-medium --effort medium --output-format text
Do dłuższych zadań uruchamiaj w tle i przechwytuj wynik do plików:
cmd /c 'type ".tools\zadanie.txt" | "%LOCALAPPDATA%\agy\bin\agy.exe" --model gemini-3.8-flash-medium --output-format text > out.txt 2> err.txt'Po zakończeniu sprawdź rozmiar i treść out.txt oraz to, czy err.txt jest pusty. Wynik modelu to jeszcze nie wynik zadania — liczy się plik, który miał powstać.
Czego nie robić
- Nie przekazuj długiego promptu przez
Start-Process -ArgumentList. PowerShell rozbije go po spacji i zobaczysz błądunexpected argument. Wieloliniowy prompt zawsze przez stdin. - Nie wklejaj sekretów (tokenów, kluczy, haseł) do promptów ani do raportów; nie wysyłaj ich poza maszynę.
- Nie obchodź operatora wdrożeń.
agymoże przygotować zmianę i ją sprawdzić, ale publikacja idzie przezdeploy.cmd— z lockiem, snapshotem i smoke testem. - Nie ufaj samemu podsumowaniu. Model potrafi zgłosić „gotowe", gdy plik nie istnieje albo nie spełnia walidacji.
Jak sprawdzić wynik
Po zadaniu zleconym do agy wykonaj krótką kontrolę w tej kolejności:
- Plik: czy artefakt istnieje i ma sensowny rozmiar?
- Format: czy JSON/HTML/kod się parsuje (np.
node --check,JSON.parse)? - Reguły: czy spełnia limity projektu (dla paczek: 4 różne odpowiedzi, limity znaków, do 2 MiB)?
- Treść: czy to, co powstało, odpowiada poleceniu — plik po pliku, a nie „na oko"?
- Publikacja: deploy przez
deploy.cmdi sprawdzenie na żywo (pobranie pliku, ekran aplikacji).
Model jest wykonawcą; odpowiedzialność za wynik zostaje po stronie zlecającego.
Przykład z praktyki
Przy audycie 200 pytań karty rowerowej agy na modelu claude-sonnet-5-5-medium dostał zadanie sprawdzenia treści i spójności obrazków. Zgłosił 3 błędy merytoryczne (m.in. odległość znaku D-2 zależna od prędkości, czerwony krzyż B-36, zakres B-6) oraz 18 uwag do obrazków — od mylących zdjęć znaków poziomych po brakujący obrazek D-50. Wszystkie poprawki przeszły walidację i zostały wdrożone jednym deployem.
Wniosek: mocniejszy model do zadania „sprawdź i popraw" zwrócił się natychmiast — zgłoszenia były konkretne i weryfikowalne, a nie ogólne.
Checklista przed zleceniem
- Jaki to typ zadania: deploy, kod, audyt, research? Do tego dobierz model.
- Czy prompt jest w pliku UTF-8 i wchodzi przez stdin?
- Czy podałeś absolutne ścieżki, format wyniku i miejsce zapisu?
- Czy zabroniłeś deployu i edycji katalogu produkcyjnego, jeśli to nie ich kolej?
- Czy po zakończeniu sprawdzisz artefakt, a nie tylko podsumowanie?
- Czy publikacja idzie przez
deploy.cmdi kończy się smoke testem?
Jeśli wszystkie odpowiedzi są „tak" — model jest narzędziem, a nie źródłem ryzyka.