Jedna tabela zamiast dziesięciu testów
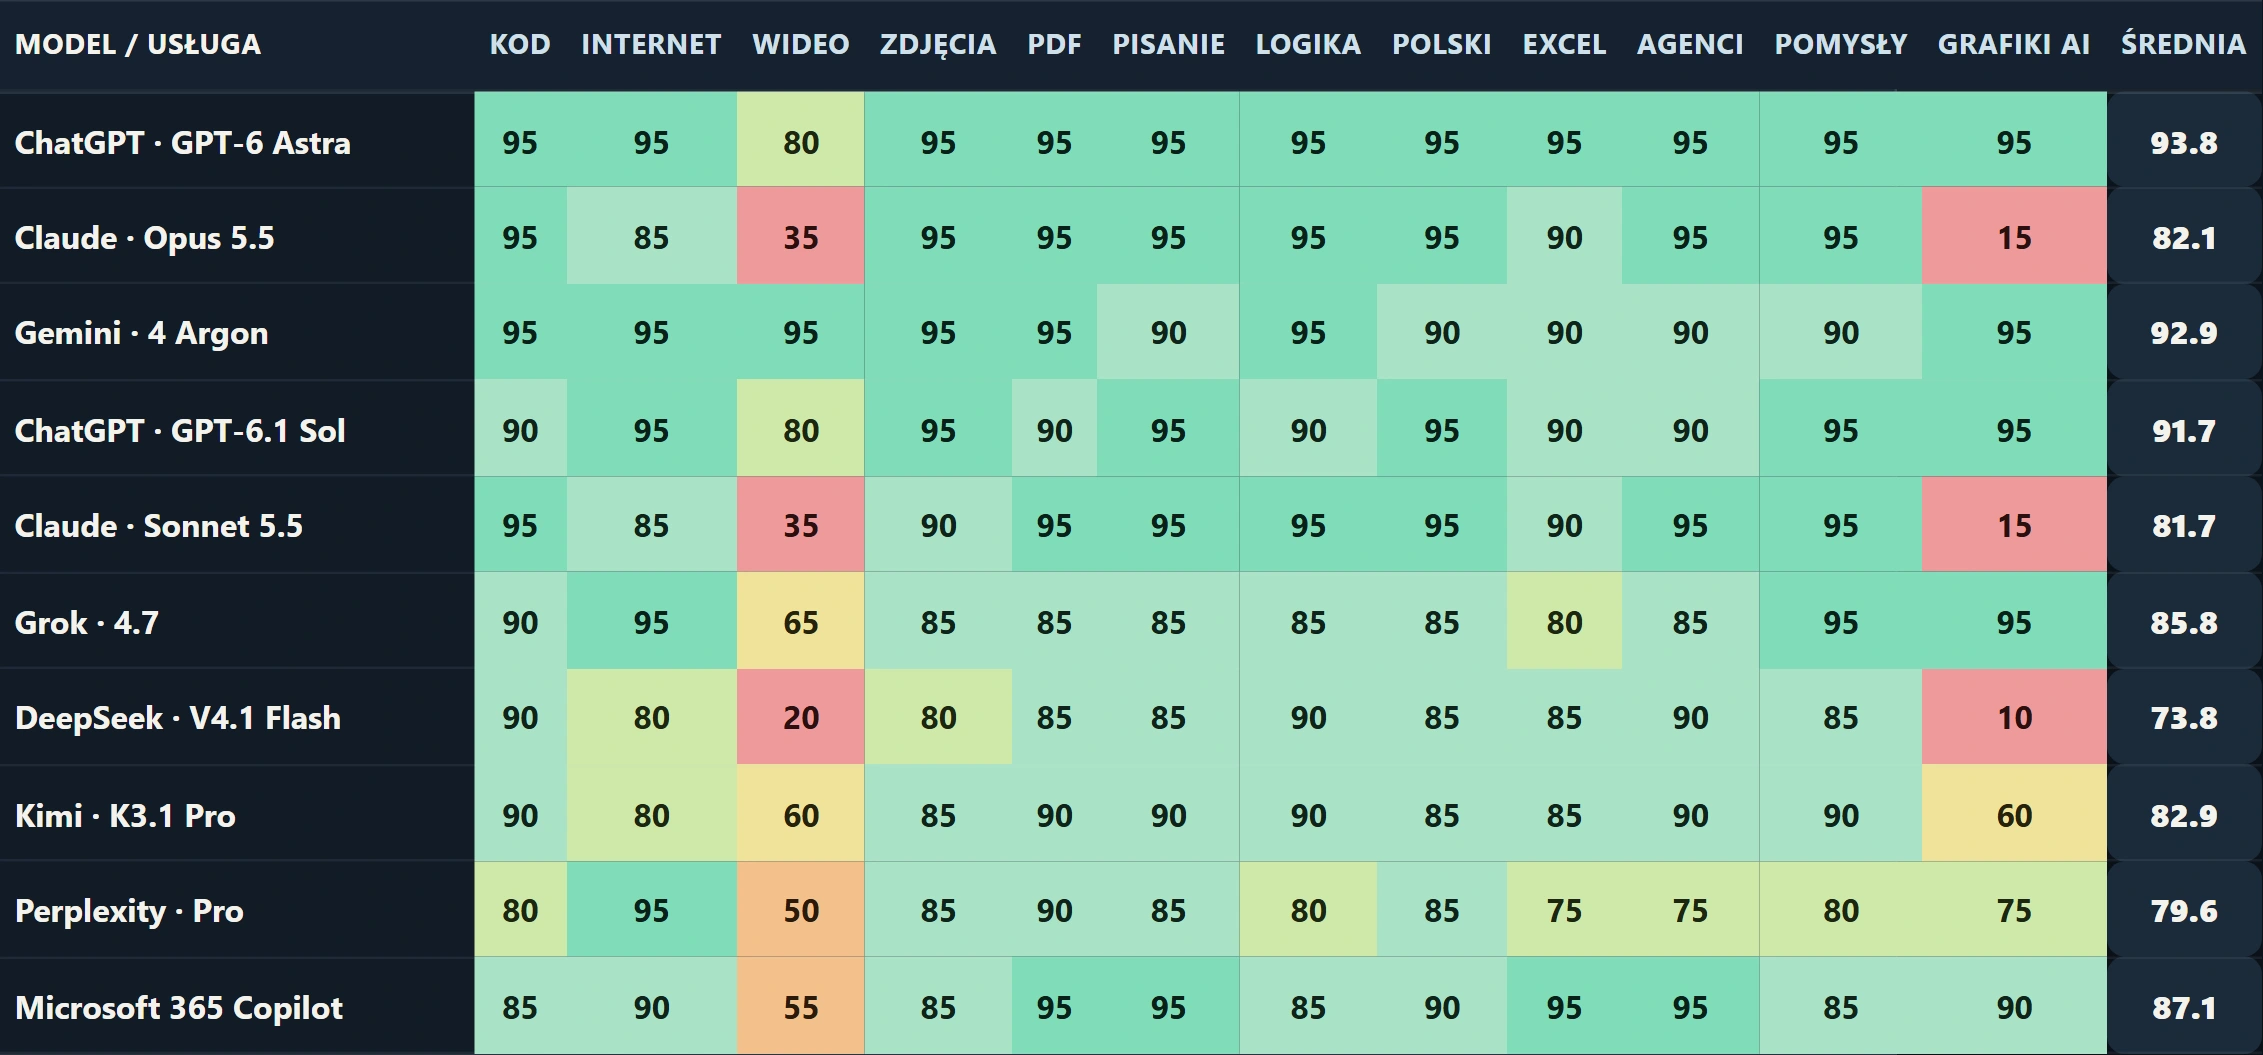
Modele AI nie różnią się już „ogólnie lepsze czy gorsze". Różnią się profilami możliwości: jeden świetnie pisze, inny analizuje nagrania, inny siedzi w pakiecie biurowym. Poniższa tabela zbiera 10 najczęściej używanych modeli i usług i ocenia je w skali 0–100 w 12 zastosowaniach — od kodu i internetu po grafiki i „pomysły".
Oceny są szacunkowe i praktyczne. Pokazują, czego realnie można oczekiwać w codziennej pracy, a nie wyniki jednego benchmarku. Kolumna „Średnia" jest bez wag i nie jest rankingiem naukowym — to tylko skrót.
| Model / usługa | KOD | INTERNET | WIDEO | ZDJĘCIA | PISANIE | LOGIKA | POLSKI | EXCEL | AGENCI | POMYSŁY | GRAFIKI AI | ŚREDNIA | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ChatGPT · GPT-6 Astra | 95 | 95 | 80 | 95 | 95 | 95 | 95 | 95 | 95 | 95 | 95 | 95 | 93.8 |
| Claude · Opus 5.5 | 95 | 85 | 35 | 95 | 95 | 95 | 95 | 95 | 90 | 95 | 95 | 15 | 82.1 |
| Gemini · 4 Argon | 95 | 95 | 95 | 95 | 95 | 90 | 95 | 90 | 90 | 90 | 90 | 95 | 92.9 |
| ChatGPT · GPT-6.1 Sol | 90 | 95 | 80 | 95 | 90 | 95 | 90 | 95 | 90 | 90 | 95 | 95 | 91.7 |
| Claude · Sonnet 5.5 | 95 | 85 | 35 | 90 | 95 | 95 | 95 | 95 | 90 | 95 | 95 | 15 | 81.7 |
| Grok · 4.7 | 90 | 95 | 65 | 85 | 85 | 85 | 85 | 85 | 80 | 85 | 95 | 95 | 85.8 |
| DeepSeek · V4.1 Flash | 90 | 80 | 20 | 80 | 85 | 85 | 90 | 85 | 85 | 90 | 85 | 10 | 73.8 |
| Kimi · K3.1 Pro | 90 | 80 | 60 | 85 | 90 | 90 | 90 | 85 | 85 | 90 | 90 | 60 | 82.9 |
| Perplexity · Pro | 80 | 95 | 50 | 85 | 90 | 85 | 80 | 85 | 75 | 75 | 80 | 75 | 79.6 |
| Microsoft 365 Copilot | 85 | 90 | 55 | 85 | 95 | 95 | 85 | 90 | 95 | 95 | 85 | 90 | 87.1 |
- mniej niż 40 — słabo / brak
- 40–59 — ograniczenia
- 60–74 — umiarkowanie
- 75–84 — dobrze
- 85–94 — bardzo dobrze
- 95–100 — czołówka
WIDEO = analiza nagrania • GRAFIKI AI = generator obrazu dostępny w usłudze • ŚREDNIA = bez wag, nie jest rankingiem naukowym.
Co z tego wynika — trzy wnioski
Poza podium warto zapamiętać dwie rzeczy. Claude Opus 5.5 i Sonnet 5.5 to znakomite narzędzia do pisania i kodu (95 i 95), ale bardzo słabe w wideo (35) i grafice AI (15) — nie wybieraj ich do pracy z obrazem. Perplexity Pro wygrywa w internecie (95), ale w Excelu i agentach ma 75 — sprawdza się jako wyszukiwarka z syntezą, nie jako arkusz.
Model do zadania — krótka ściągawka
| Zadanie | Pierwszy wybór | Alternatywa |
|---|---|---|
| Kod, poprawki, debugowanie | GPT-6 Astra (95) / Opus 5.5 (95) | DeepSeek V4.1 Flash (90) — najtaniej |
| Analiza nagrań i wideo | Gemini 4 Argon (95) | Grok 4.7 (65) / Kimi K3.1 Pro (60) |
| Zdjęcia, dokumenty, PDF | GPT-6 Astra (95) / Copilot (95) | Claude Opus 5.5 (95) przy pisaniu |
| Pisanie tekstów | Claude Opus 5.5 / Sonnet 5.5 (95) | GPT-6 Astra (95) |
| Logika i rozumowanie | Gemini 4 Argon (95) / GPT-6 Astra (95) | DeepSeek V4.1 Flash (90) |
| Excel i arkusze | Microsoft 365 Copilot (95) | GPT-6 Astra (95) |
| Agenci i automatyzacja | Claude Opus 5.5 (95) / GPT-6 Astra (95) | Gemini 4 Argon (90) |
| Grafiki AI | Gemini 4 Argon (95) | ChatGPT (95) |
Jeśli nie chcesz wybierać: GPT-6 Astra ma najwyższą średnią i nie schodzi poniżej 80 w żadnej kategorii. To najlepszy „jeden model do wszystkiego" w tym zestawieniu.
Czego tabela nie mówi
- Oceny są szacunkowe. To praktyczna przydatność, nie wyniki jednego benchmarku — dwa różne testy mogą dać inne liczby.
- Wynik zależy od planu. Abonament, limity, dostęp do sieci i narzędzi (np. generatora obrazów) zmieniają to, co realnie dostajesz.
- Dostępność w Polsce bywa różna. Część funkcji jest opóźniona względem USA, a Gemini 4 Carbon ma obecnie ograniczoną dostępność.
- Średnia bez wag bywa myląca. Model świetny w 11 kategoriach i słaby w jednej może wypaść niżej niż równy „solidniak" — patrz kolumny, nie tylko ostatnia.
- Modele się zmieniają. To obraz na listopad 2026; po aktualizacji modelu oceny mogą się przesunąć.
Praktyczna zasada: wybierz model pod zadanie, nie pod markę. Do obrazu i nagrań — Gemini, do tekstu i kodu — Claude lub GPT-6 Astra, do arkuszy — Copilot, do szybkiego researchu — Perplexity.